LocalAI
@dsh-ai-providers/localai 是 Firefox2100 在本项目中维护的 LocalAI 专用集成。它与通用 OpenAI 兼容提供方分开,因此 LocalAI 特有的控制项和能力不会被显示成 OpenAI 功能。它不是 DSH 或 LocalAI 官方软件包。
该软件包依赖与提供方无关的 @dsh-ai-providers/openai-compatible 传输库,而不依赖 OpenAI 提供方插件。两个插件可以独立安装,同时复用共有的协议实现。
能力
该软件包注册:
- 流式对话与视觉语言模型;
- 嵌入;
- 重排;
- 决策;
- 文本转语音;
- 文件及实时语音转文本;
- 图像生成。
只应启用 LocalAI 当前所加载模型实际实现的服务。
连接
打开 设置 > 提供方 > LocalAI 连接。默认连接为 http://localhost:8080/v1。LocalAI 位于其他主机或代理之后时应修改此地址。API 密钥是可选的;启用认证时,在连接中填写凭据名称,并通过 DSH 凭据服务保存其值。
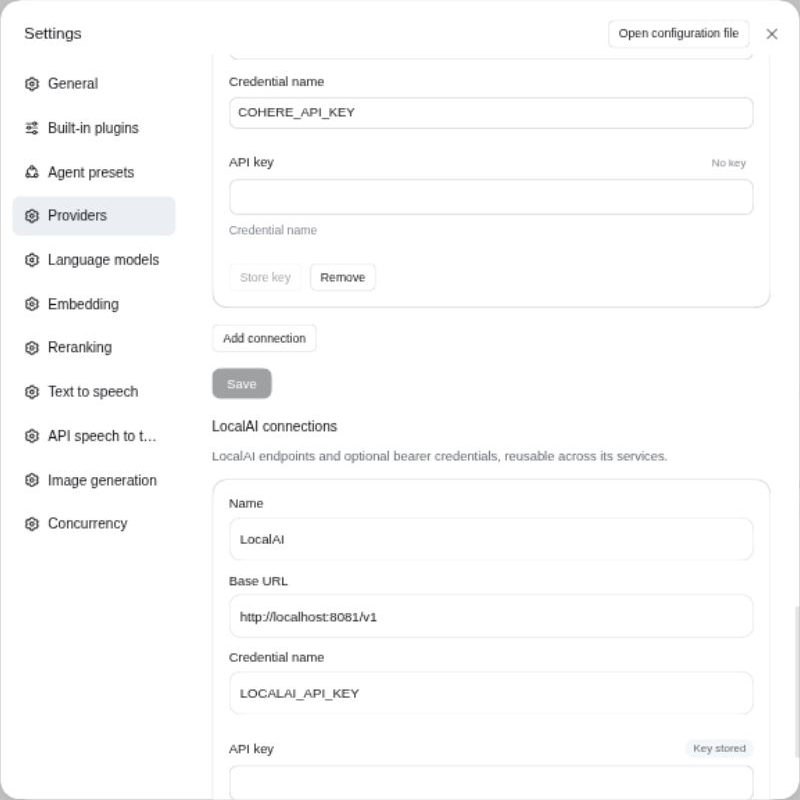
所有能力共用连接列表。每项服务页面分别选择连接和准确的模型名称,并在该服务旁配置 LocalAI 原生请求字段。
语言模型
语言模型使用 LocalAI 的 OpenAI 兼容 POST /chat/completions 流。路由和模型支持通用采样字段,以及 top_k、min_p、重复惩罚、推理处理、自定义请求头和 sampling.body 中的任意顶层请求字段。
LocalAI 原生或后端专用选项(例如约束语法及采样器控制)可放入 sampling.body。先应用路由值,再由模型值覆盖。
模型管理
LocalAI 路由支持通过 ctx.aiModels 暴露的可选模型管理 API:状态查询使用 GET /backend/monitor,加载使用 POST /backend/load,卸载使用 POST /backend/shutdown,路径均相对于已配置的 /v1 基础 URL。状态结果包含 LocalAI 后端状态,并在服务端提供时包含以字节计的内存用量。
LocalAI 启用认证后,这些端点需要管理员权限,因此连接凭据必须具备相应权限。加载和卸载会改变服务器共享状态;只有在调用方负责模型生命周期并已处理并发请求时才应使用。
重排
重排会相对于已配置的 /v1 基础 URL 调用 POST /rerank。rerankModel 应填写 LocalAI 提供的模型名称。rerankBody 会合并到每次请求中,用于后端专用参数;查询、文档、模型、top_n 和 return_documents 仍由服务调用控制。
决策
决策会相对于已配置的 /v1 基础 URL 调用 POST /systemone。这是 LocalAI 提供决策模型的 System One API:决策模型一次性返回带类型的答案和概率。decisionModel 应填写 LocalAI 中以 known_usecases: [decisions] 声明的模型名称。decisionBody 会合并到每次请求中,用于后端专用字段;模型、状态和问题仍由服务调用控制。
决策模型要求 LocalAI 的版本和 llama-cpp 后端构建支持它们。请用“决策”标签页中的连接测试确认你的安装能否提供该模型。使用方的用法请参阅决策。
语音、嵌入与图像
这些服务使用 LocalAI 对应的 OpenAI 兼容端点。模型 ID、声音、格式和图像选项取决于 LocalAI 后端配置,应按服务实际提供的名称填写。embeddingBody、ttsBody 和 imageBody 可加入后端专用 JSON 字段;输入、模型、声音和提示词等标准字段仍由服务控制。部署提供兼容的实时 WebSocket 端点时,可以使用实时转录。
LocalAI 图像生成始终调用 POST /images/generations,不会使用 /images/edits。参考图处理可以配置为三种模式:忽略参考图;把第一张图放入 files,用于图生图;或把全部图片放入 ref_images,交给支持参考图的后端。highRes 会按配置的倍率进行第二次图生图渲染。提供方还支持单次请求的 steps、negativePrompt 和 seed 字段,最终是否可用取决于已加载的后端。
何时使用此软件包
LocalAI 部署应使用 @dsh-ai-providers/localai;OpenAI 或其他兼容服务器继续使用 @dsh-ai-providers/openai。两者提供方 ID 不同,可以同时安装。