Ollama
@dsh-ai-providers/ollama 是 Firefox2100 在本项目中维护的 Ollama 原生提供方。它直接使用 Ollama 自己的 API,而不是其 OpenAI 兼容层,因为原生 API 提供了兼容层所没有的请求控制项。它不是 DSH 或 Ollama 官方软件包。
支持能力
| 能力 | 原生端点 |
|---|---|
| 语言模型 | POST /api/chat(按行分隔的 JSON 流) |
| 模型发现 | GET /api/tags,再对每个模型调用 POST /api/show |
| 模型控制 | 状态用 GET /api/ps;加载用不带提示词的 POST /api/generate,卸载则加上 keep_alive: 0 |
| 嵌入 | POST /api/embed |
本插件不涉及 Ollama 的重排、TTS、STT 或图像生成,因此不会注册这些服务。
配置连接
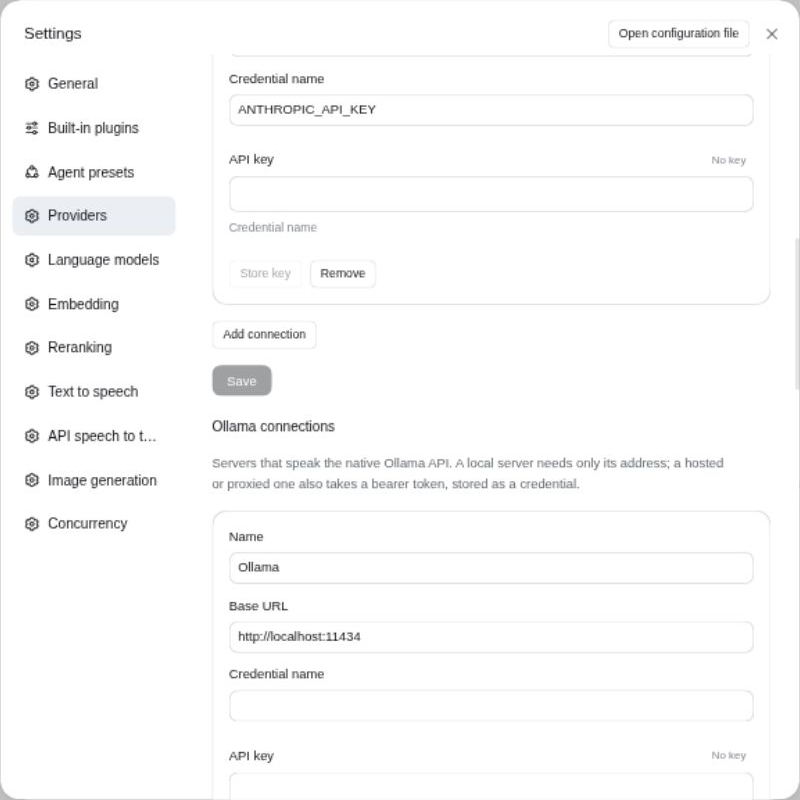
打开 设置 > 提供方 > Ollama 连接。默认连接指向本地服务器:
| 设置 | 默认值 |
|---|---|
| 基础 URL | http://localhost:11434(末尾带不带 /api 均可) |
| 凭据引用 | 空:本地服务器不需要密钥 |
| 流静默上限 | 5 分钟 |
| 嵌入请求超时 | 2 分钟 |
托管或经代理的服务器,请填写凭据名称并保存令牌;它会作为 Authorization: Bearer 发送。密钥通过 DSH 凭据服务保存,不会写入配置档案。
配置路由与模型
创建路由,选择连接,并按 Ollama 中的确切名称添加模型(例如 qwen3:8b)。点击 列出服务器上的模型 会查询 /api/tags 和 /api/show,并按服务器报告的能力添加模型:图像输入、思考和上下文窗口。只用于嵌入的模型不会出现在列表中。
支持思考的模型会通过发现得到推理等级:多数模型为 关 和 开(think: false 与 think: true);gpt-oss 只接受等级、无法关闭思考,因此是 低、中、高。
:::warning 请设置 numCtx
模型的上下文窗口是它所支持的长度,而 Ollama 为一次请求分配的上下文是 num_ctx。请求没有设置时,服务器使用自己的默认值,往往只有 4096 个 token 甚至更少,过长的提示词会从开头被悄悄截掉。DSH 依据模型的 contextWindow 决定何时压缩对话,所以两者必须一致:请在路由或模型上把 numCtx 设为你愿意占用内存的上下文长度。提供方不会替你调高它,因为模型的最大长度所需内存可能远超机器所有。
:::
控制项
路由、模型和策略的采样设置在同一个对象里,既有所有提供方通用的字段,也有 Ollama 自己的字段。缺省表示使用服务器默认值。
| 字段 | 请求字段 | 说明 |
|---|---|---|
temperature、topP、topK、minP、seed、stop | options.* | 通用字段 |
frequencyPenalty、presencePenalty | options.frequency_penalty、options.presence_penalty | 通用字段 |
repetitionPenalty | options.repeat_penalty | 通用字段 |
maxTokens | options.num_predict | 通用字段;未设置时使用模型的输出上限 |
numCtx | options.num_ctx | 见上方提示 |
repeatLastN、typicalP、penalizeNewline | options.repeat_last_n、typical_p、penalize_newline | |
mirostat、mirostatTau、mirostatEta | options.mirostat* | |
numKeep、numBatch、numGpu、mainGpu、numThread、useMmap | options.* | 运行时调优 |
keepAlive | keep_alive | 5m、1h,-1 表示一直保留,0 表示立即卸载 |
think | think | true、false,或 low、medium、high |
format | format | json,或答案必须遵循的 JSON Schema |
body | 顶层 | 服务器接受的其他任何字段 |
聊天所选的推理等级,以及 body,优先于带类型的字段。toolChoice: none 会不提供工具。Ollama 无法要求必须调用工具,因此 required 和指定工具无法强制,由模型自行决定。
原生请求映射
提供方支持系统提示、文本与图像内容(图像以 base64 发送,模型需标记为支持视觉)、工具声明与工具结果、流式文本、思考和工具调用,以及 token 用量。Ollama 返回的工具调用是完整的、没有标识,提供方会为每个调用生成标识;工具结果则按工具名称对应。文件仍是工具可读的文本句柄,已卸载的图像仍是占位符。
嵌入
在 嵌入 标签中选择 Ollama,选好连接和模型(默认 nomic-embed-text)。文本按 batchSize 分批发送。可设置:
- 向量维度:适用于可缩短向量的模型,也是会话第一次请求前就要选定的请求选项。
- 上下文(
num_ctx) 与 超出上下文的文本:截断以适应(默认)或拒绝。 - 保持加载:请求后模型在内存中保留多久。
Ollama 不区分查询与文档,因此 inputType 会被忽略。
错误与取消
HTTP 和流式失败会映射为 DSH 语言模型的失败类别:认证、限流、用量上限、无效请求(包括尚未拉取的模型)、上下文溢出、服务器故障、超时和取消。服务器在流中途报告的错误以同样方式分类。